Contexte temporel
Plus d’images, plus de gain
D’une à sept images, NOEMA passe de 28,7 % à 42,7 % à taille constante. Le Context MLP grossit avec son entrée mais plafonne dès cinq images.
Décoder la parole naturelle à partir de l’IRMf grâce à la modélisation temporelle et à l’alignement multimodal
de précision top-10 parmi 2 000 segments, sur des sessions et une parole inédites
des segments retrouvés en première position
points de plus que le meilleur modèle de référence
paramètres, 2,5× moins que le meilleur modèle de référence
01Modèle
NOEMA décode d’une session à l’autre et d’un stimulus à l’autre : il est testé sur des sessions entières mises de côté pendant l’entraînement, avec une parole qu’il n’a jamais entendue. Écouter de la parole suscite une activité cérébrale soutenue, et l’information qu’elle porte s’étale sur plusieurs secondes, si bien qu’un seul instantané du cerveau n’en contient qu’une partie. NOEMA lit donc sept images consécutives plutôt qu’une seule, soit environ 15 secondes d’activité cérébrale, et prédit une représentation de ce que le participant a entendu juste avant l’image centrale.
Une même couche linéaire projette les 20 484 sommets corticaux de chaque image sur 4 096 dimensions, image par image, dans l’ordre.
Deux convolutions temporelles résiduelles, de dilatations 1 et 2, permettent à chaque position de combiner ses voisines.
Seule la position centrale est projetée dans l’espace des stimuli à 8 704 dimensions. Elle voit les sept images.
Survolez ou touchez une unité pour voir les images qu’elle lit.
Chaque prédiction est comparée à une cible construite par trois encodeurs figés. Les encodeurs de texte et d’audio résument les 10 dernières secondes de parole, pour le contexte ; un encodeur de reconnaissance vocale ne couvre que les 2 dernières secondes, pour la précision temporelle. Chaque représentation est normalisée, puis les trois sont concaténées.
L’entraînement est contrastif, comme pour CLIP : dans chaque lot, une prédiction doit être plus proche du segment réellement entendu que de tous les autres. Au test, NOEMA ne voit que l’IRMf ; les encodeurs servent seulement à précalculer les candidats.
normalisées, puis concaténées
Cible de 8 704 dimensions
NOEMA tient sur un écran : voici sa définition PyTorch complète, tirée de l’annexe de l’article. Entraînez-le sur Cephalonauts One, diffusé depuis Hugging Face, ou confiez le prompt à votre agent de code pour qu’il prépare tout à votre place.
Le modèle
import torch.nn as nn


class TCNblock(nn.Module):
    def __init__(self, hidden_dim, dilation):
        super().__init__()
        self.layers = nn.Sequential(
            nn.Conv1d(hidden_dim, hidden_dim, kernel_size=3,
                      padding=dilation, dilation=dilation),
            nn.GELU(),
            nn.Conv1d(hidden_dim, hidden_dim, kernel_size=1),
        )
        self.norm = nn.LayerNorm(hidden_dim)

    def forward(self, x):
        # x: (batch, frames, hidden_dim)
        return self.norm(
            x + self.layers(x.transpose(1, 2)).transpose(1, 2)
        )


class NOEMA(nn.Module):
    def __init__(self, input_dim, output_dim=8704,
                 hidden_dim=4096, dropout=0.7):
        super().__init__()
        self.spatial = nn.Sequential(
            nn.Linear(input_dim, hidden_dim),
            nn.GELU(),
            nn.Dropout(dropout),
        )
        self.temporal = nn.Sequential(
            TCNblock(hidden_dim, dilation=1),
            TCNblock(hidden_dim, dilation=2),
        )
        self.output = nn.Linear(hidden_dim, output_dim)

    def forward(self, x):
        # x: (batch, frames, input_dim)
        x = self.temporal(self.spatial(x))
        # project the central frame
return self.output(x[:, x.shape[1] // 2])Demandez à votre agent
Lis la publication NOEMA [1] et explore le jeu de données Cephalonauts One [2]. Implémentons NOEMA, entraînons-le sur un participant et vérifions sa précision top-10@2000 sur la session de test ! [1] https:// arxiv.org/ abs/ 2610.22049 [2] https:/ / huggingface.co/ datasets/ karavela/ cephalonauts_one
02Résultats
Nous évaluons NOEMA sur deux jeux de données d’écoute naturelle approfondis. Cephalonauts One, le nôtre, suit 3 personnes pendant environ 30 heures chacune, à l’écoute de documentaires radio en français, non scénarisés. LeBel, collecté à l’Université du Texas à Austin, suit des personnes écoutant des histoires de podcasts en anglais (The Moth Radio Hour, Modern Love) ; nous utilisons ses 3 participants les plus enregistrés, environ 16 heures chacun.
Chaque décodeur est entraîné séparément pour chaque participant et évalué sur des sessions entières mises de côté, dont il n’a jamais entendu la parole, en classant environ 2 000 segments candidats. NOEMA place le bon segment dans son top 10 pour 42,7 % des requêtes en français et 43,6 % en anglais, contre 0,5 % au hasard. Il dépasse aussi le Context MLP, qui voit les mêmes sept images avec 2,5 fois plus de paramètres : le gain vient de la façon de combiner les images, pas d’une entrée plus riche.
Comment la recherche est évaluéeLa fréquence à laquelle le segment entendu figure parmi les 10 premiers d’environ 2 000 candidats. Plus c’est haut, mieux c’est. Cephalonauts One : 3 participants, 30 heures chacun de podcasts en français.
Les barres montrent la moyenne des 3 participants, et les points la moyenne de chaque participant sur 5 plis.
Des ablations contrôlées, réentraînant chaque fois les décodeurs depuis zéro, isolent les deux ingrédients de NOEMA : la structure temporelle et des cibles complémentaires.
Contexte temporel
D’une à sept images, NOEMA passe de 28,7 % à 42,7 % à taille constante. Le Context MLP grossit avec son entrée mais plafonne dès cinq images.
Cibles de stimulus
Ajouter l’audio, puis la parole, à une cible texte aide tous les décodeurs pour tous les participants, NOEMA le plus : de 27,6 % à 42,7 %.
Ordre des images (Cephalonauts One)
Mélangez toutes les fenêtres de la même façon et réentraînez : le Context MLP réapprend simplement ses poids, NOEMA perd 4,3 points. Ses convolutions supposent des images dans l’ordre chronologique.
Précision top-10@2000 moyennée sur les 3 participants, avec 5 plis chacun.
Un décodeur utile doit choisir dans un ensemble ouvert. Nous avons ajouté jusqu’à 8 494 segments de dix secondes, tirés de 50 autres épisodes du même podcast absents du jeu de données, à chaque ensemble de test d’environ 2 000, sans réentraîner. Le segment entendu recule de 66 places pour NOEMA, contre 112 pour le Context MLP et 191 pour le MLP, et reste en médiane dans le top 0,8 % de NOEMA.
Moyenne des 3 participants de Cephalonauts One sur 5 plis.
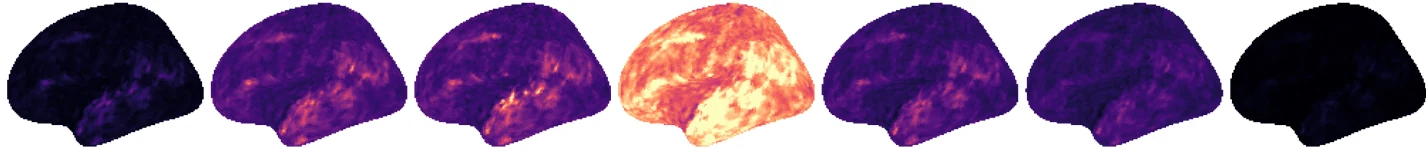
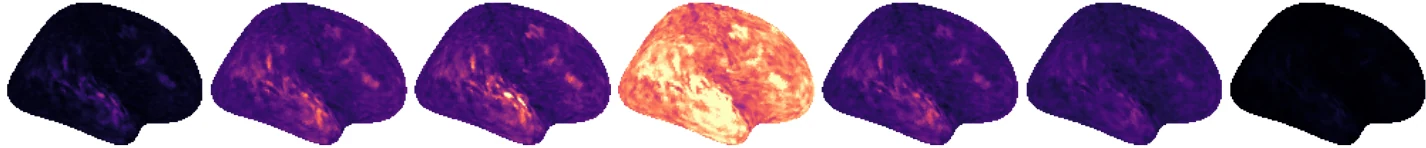
Des cartes de gradients intégrés montrent les entrées auxquelles les prédictions de NOEMA sont les plus sensibles. La sensibilité culmine sur l’image centrale et, sur le cortex, se concentre dans des régions temporales latérales et frontales cohérentes avec le réseau du langage, alors que le modèle n’avait aucun a priori sur l’emplacement du langage.
RemarqueCes cartes décrivent la sensibilité du modèle, pas un rôle causal de ces régions. Elles ne montrent pas non plus la latéralisation gauche du langage, qui pourrait nécessiter des modèles plus grands.
 Droite
 Temps (s)−6,2−4,2−2,10+2,1+4,2+6,2
@misc{caris2026noema, title = {Decoding naturalistic speech from {fMRI} with temporal modeling and multimodal alignment}, author = {Caris, Corentin and Jalouzot, Louis and Rajabi, Nona and Ilinca, G{\'e}raud and Hassayoune, Ahmed and Muminov, Asilbek and Delebarre, Thadd{\'e}e and Fonteneau, Clara and Maussion, Charles and Thirion, Bertrand and Thual, Alexis and Collas, Antoine}, year = {2026}, eprint = {2610.22049}, archivePrefix = {arXiv}, url = {https://arxiv.org/abs/2610.22049}}
Entraînez-le sur Cephalonauts One, lisez le code du modèle, puis essayez de faire mieux. Partagez vos résultats avec nous et d’autres chercheurs sur Discord.