
sub-029,94 heures
24 sessions · 120 acquisitions
Un jeu de données IRMf approfondi pour décoder la parole naturelle dans le cerveau humain
Maillage adapté de “Human head” par ADAMA, CC BY 4.0
participants
heures par participant
heures de stimuli uniques
volumes IRMf
01Jeu de données
Trois participants ont chacun passé 24 sessions dans le scanner, à raison de cinq acquisitions par session, à écouter des épisodes de podcasts en français : des récits spontanés où des personnes parlent de leur vie, de leurs relations et de ce qu’elles ressentent. Lancez un extrait ci-dessous pour suivre les mots et l’activité cérébrale qu’ils ont suscitée.
Et il y a 3 maisons. Les plus petits ont la leur, il y en a une autre pour les ados à partir de 15 ans et la troisième est la plus importante.
And there are three houses. The youngest children have their own; there is another for teenagers aged fifteen and over, and the third is the most important.
Le jeu de données est hébergé sur Hugging Face et le décodeur de référence sur GitHub. Chargez les données directement en Python avec la bibliothèque datasets : l’extrait ci-dessous charge les données d’entraînement d’un participant sur la surface fsaverage5, sans tout télécharger au préalable. Ou confiez la consigne à votre agent de code et laissez-le mettre en place le décodeur de référence.
Charger les données
from datasets import load_dataset

ds = load_dataset(
    "karavela/cephalonauts_one",
    name="sub-1_fsaverage5",
    split="train",
    streaming=True,
)Demander à votre agent
Lis l’article Cephalonauts One [1] et explore le jeu de données Cephalonauts One [2]. Mettons en place l’entraînement du décodeur de référence, puis essayons de faire mieux ! [1] https:// arxiv.org/ abs/ 2610.03558 [2] https:/ / huggingface.co/ datasets/ karavela/ cephalonauts_one
Chacun des trois participants a passé environ 30 heures dans le scanner au fil de 24 sessions, à écouter des podcasts en français : 90 heures d’IRMf du cerveau entier, en 358 acquisitions. Les sessions de chaque participant sont réparties de la même façon : 22 pour l’entraînement, une pour la validation et une réservée au test.
Enregistrements 3T du cerveau entier dans un espace volumique et sur la surface corticale.
Les épisodes de podcast, tels qu’entendus dans le scanner.
Texte en français, aligné dans le temps mot à mot sur les enregistrements cérébraux.
Caractéristiques audio et textuelles alignées dans le temps sur les acquisitions.
Chaque bloc correspond à une session. La session de test change d’un pli à l’autre.
02Benchmark
Le benchmark demande à un modèle de retrouver ce qu’un participant a entendu à partir de ses seuls enregistrements cérébraux. Chaque extrait de parole Z est diffusé au participant, ce qui donne des enregistrements IRMf prétraités X, et passe aussi par un encodeur audio ou textuel pré-entraîné, qui produit des représentations du stimulus Y. Un décodeur fθ apprend à prédire Y à partir de X.
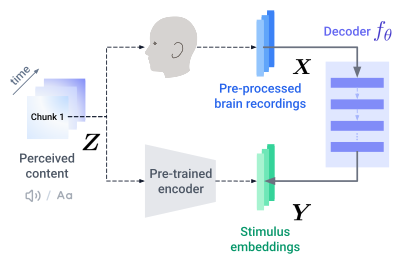
Pour évaluer le décodeur, chacune de ses prédictions sur les sessions réservées au test est comparée aux représentations de 2 000 passages de parole candidats, classés par similarité. Le décodage est réussi lorsque le passage réellement entendu figure parmi les 10 plus proches : c’est la précision top-10@2000 présentée ci-dessous.
Voir la section Méthodes de l’articleNous avons entraîné le décodeur sur 1 à 30 heures d’enregistrements de chaque participant, puis l’avons évalué de cette façon sur les sessions réservées au test. Pour les trois participants, le décodage continue de s’améliorer à mesure que les données d’entraînement augmentent, sur toute la plage mesurée.
Voir la section Méthodes de l’articleFréquence à laquelle le bon passage figure parmi les 10 premiers classés par le modèle, sur 2 000 candidats. Plus c’est élevé, mieux c’est.
Lignes : moyenne sur 5 plis · Bandes : ±1 ET · fsaverage5
@inproceedings{collas2026cephalonauts, title = {{Cephalonauts One}: A deep {fMRI} dataset for decoding naturalistic speech in the human brain}, author = {Collas, Antoine and Jalouzot, Louis and Ilinca, G{\'e}raud and Caris, Corentin and Valabr{\`e}gue, Romain and Hassayoune, Ahmed and Goncalves, David and Hueber, Madeleine and Delebarre, Thadd{\'e}e and Savatovsky, Julien and Fonteneau, Clara and Maussion, Charles and Thirion, Bertrand and Thual, Alexis}, booktitle = {Advances in Neural Information Processing Systems (NeurIPS), Track on Evaluations and Datasets}, year = {2026}, eprint = {2610.03558}, archivePrefix = {arXiv}, url = {https://arxiv.org/abs/2610.03558}}
Nous recrutons des volontaires en bonne santé pour Cephalonauts One, notre étude d’IRM cérébrale en cours. Inscrivez-vous sur la liste d’attente pour passer quelques sessions dans le scanner, en apprendre davantage sur votre propre cerveau et contribuer aux données qui manquent encore à la recherche sur le cerveau.